The Crawler Zoo перетворює журнали запитів до сайту на живу вітрину автоматизованих відвідувачів. Найпомітніша частина проєкту – прихована адреса /trap/, яку robots.txt просить не обходити. Запит до неї не доводить зловмисного наміру, але показує, що конкретний клієнт не дотримався цієї інструкції.
П’ять зон для пошукових, SEO та preview-ботів
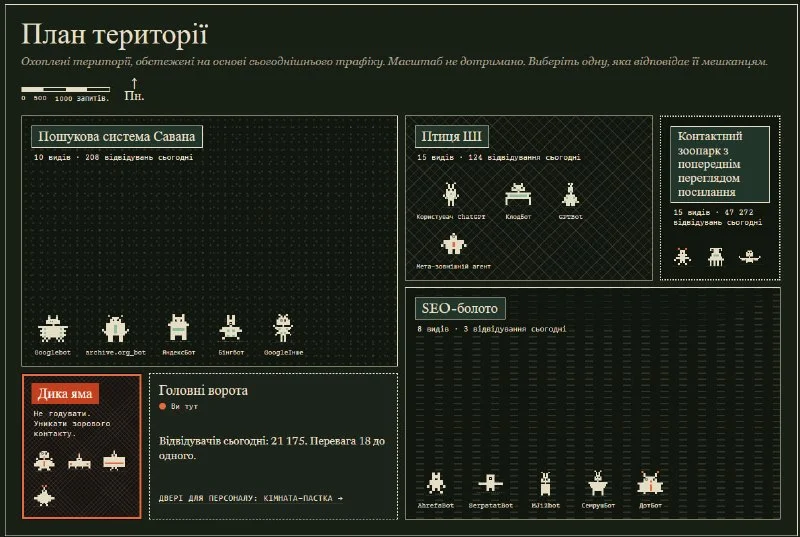
Сайт розподіляє автоматизованих гостей за тематичними зонами. У Search Engine Savanna показують пошукових краулерів на кшталт Googlebot, Bingbot і YandexBot. Окремо відображають GPTBot і ClaudeBot, а SEO Swamp містить сканери AhrefsBot та SemrushBot. У Link-Preview Petting Zoo зібрано ботів для створення попереднього перегляду посилань, зокрема Slackbot. Для невідомих або некерованих HTTP-клієнтів передбачено Feral Pit, де прикладом названо curl.
The Crawler Zoo повідомляє, що частину великих ботів, зокрема Googlebot, Bingbot і GPTBot, перевіряє за мережевими даними їхніх операторів. Водночас це власна методика проєкту, а не незалежний аудит точності класифікації кожного відвідувача.
Disallow: /trap/ не зупиняє запит технічно
У robots.txt проєкту є правило `Disallow: /trap/`. Воно повідомляє краулерам, що цю адресу не варто відвідувати, але не створює заборони на рівні сервера. Саме тому запит до /trap/ може бути корисним сигналом: він означає, що автоматизований клієнт дістався прихованого посилання та проігнорував вказівку у robots.txt.
Для людини посилання на пастку не призначене. Його приховано на сторінках сайту, щоб перевіряти поведінку програм, які обходять доступні URL. Потрапляння до Trap Room варто трактувати обережно: воно фіксує факт запиту до забороненого шляху, а не встановлює мотив чи намір оператора бота.
Trap Room веде краулерів углиб лабіринту
Після переходу до /trap/ відвідувач потрапляє в Trap Room. Під час обходу система генерує нові кімнати, а кожна з них містить п’ять посилань далі в лабіринт. Така конструкція допомагає побачити, як довго автоматизований клієнт продовжує переходити за посиланнями, замість того щоб зупинитися на забороненому маршруті.
Проєкт також окремо рахує бот-візити й анонімні денні відвідування людей. Озвучені показники майже 400 тисяч ботів і близько 20 тисяч людей є моментним значенням лічильників, тому вони змінюються протягом дня і не є сталою пропорцією аудиторії.
WAF і rate limiting потрібні там, де robots.txt недостатньо
Robots.txt корисний для добросовісних краулерів, яким сайт хоче задати правила обходу. Але він не замінює технічний контроль доступу. Якщо автоматизовані запити створюють навантаження або небажано сканують ресурс, захист будують іншими механізмами: перевіркою походження ботів, аналізом логів, rate limiting, WAF і правилами доступу.
Саме в цьому практична цінність The Crawler Zoo: він показує різницю між корисною індексацією, сервісними ботами та клієнтами, які поводяться поза очікуваними правилами. Пастка допомагає побачити сигнал, але рішення про реакцію потребує перевірки конкретних запитів і їхнього джерела.